머스크 'Grok Bot도 Claude를 쓰겠다': 에이전트가 작업마다 다른 회사 모델을 고를 때 기업이 정할 다섯 가지
2026년 10월 7일 일론 머스크는 Grok Bot이 작업마다 가장 좋은 모델을 쓰고 Claude Opus 5.5, Midjourney, Suno 같은 다른 회사 API도 포함한다고 밝혔습니다. 발표된 것과 아직 모르는 것, 에이전트가 여러 회사 모델을 섞어 쓸 때 회사가 정해야 할 모델 배정·데이터 경계·허용 목록·기록·비용 한도를 정리했습니다.
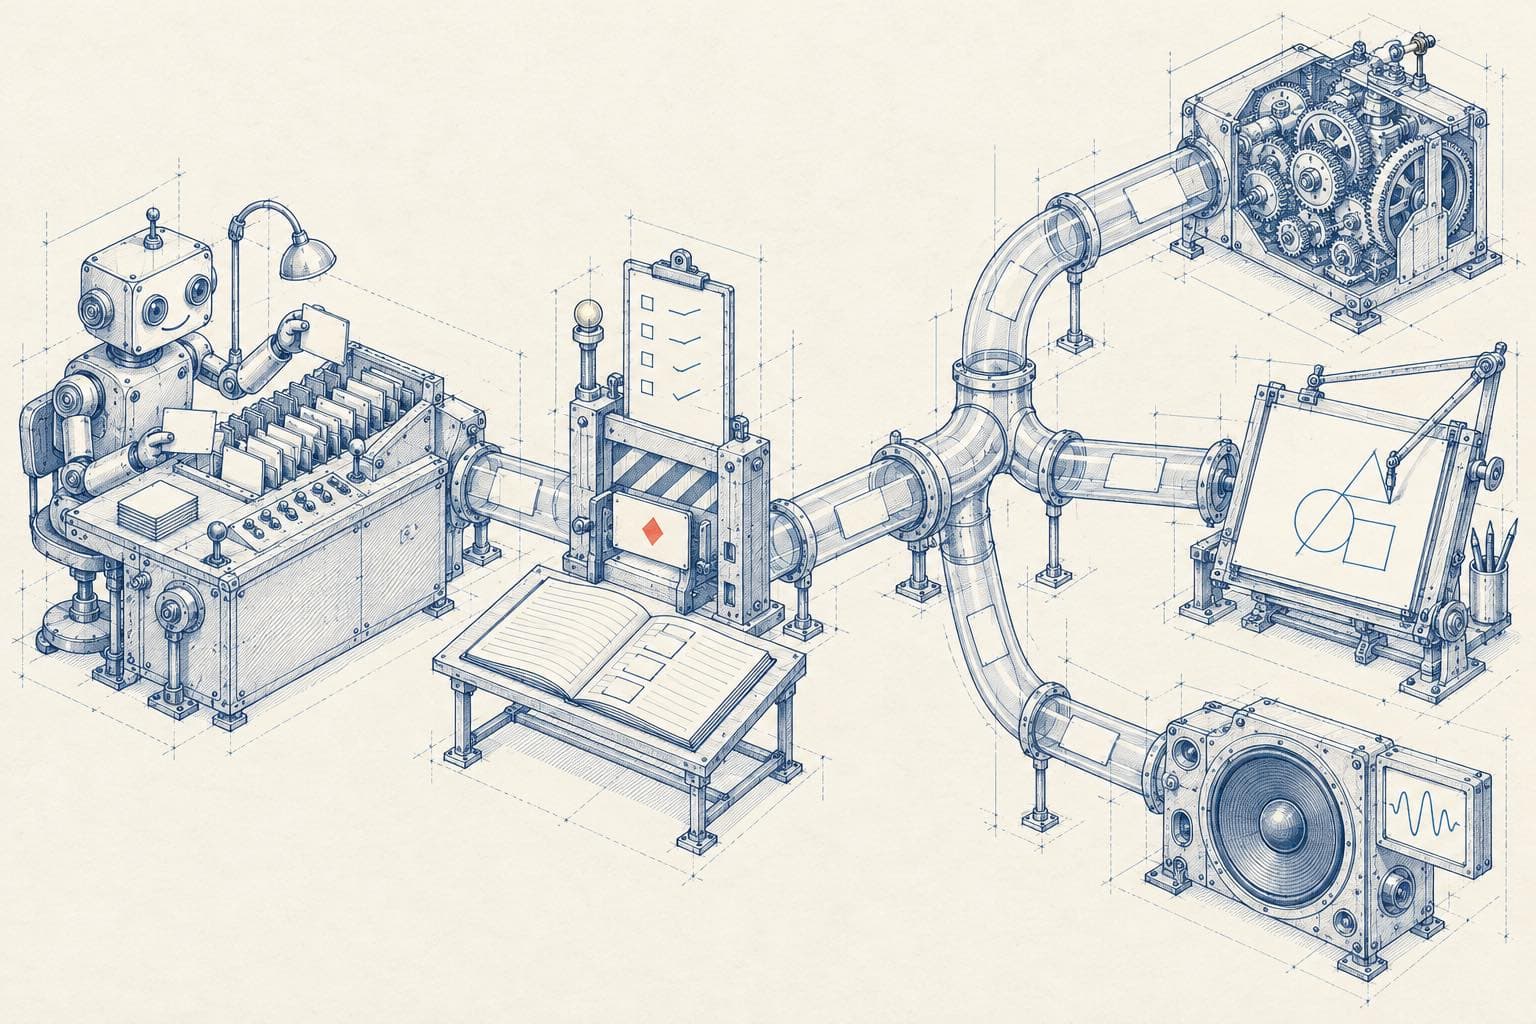
2026년 10월 7일 일론 머스크는 X에 Grok Bot이 앞으로 작업마다 가장 좋은 백엔드 모델을 쓰고, 여기에 Claude Opus 5.5, Midjourney, Suno 같은 다른 회사 API가 들어간다고 밝혔습니다. 자체 모델 Grok을 가진 회사도 에이전트 안에서는 경쟁사 모델을 섞어 쓰겠다는 뜻입니다. 회사가 쓰는 에이전트도 같은 방향으로 갑니다. 그러면 도입 질문은 '어느 모델이 최고인가'에서 '우리 데이터가 어느 회사 모델로 가고, 누가 정하고, 어떻게 기록되나'로 바뀝니다. 도입 전에 작업별 모델 배정, 데이터 경계, 허용 모델 목록의 강제 방식, 호출 기록, 비용 한도 다섯 가지를 정하세요.
머스크는 정확히 무엇을 말했나
게시물은 짧습니다. 앞으로 SpaceX가 Grok Bot의 작업마다 가장 좋은 백엔드 모델을 쓰겠다며 Claude Opus 5.5, Midjourney, Suno와 '다른 주요 API'를 예로 들었고, 가장 좋은 결과를 낼 가능성이 큰 쪽을 고르겠다고 덧붙였습니다. Grok Bot은 2026년 8월 11일 베타로 나온 항상 켜진 에이전트 제품입니다. 봇마다 클라우드 컴퓨터에서 브라우저, 파일, 터미널을 쓰고 사용자가 자리를 떠도 일합니다. 운영사는 SpaceX에 인수된 xAI(현 SpaceXAI)입니다.
발표된 것과 아직 모르는 것
| 항목 | 확인된 내용 | 아직 모르는 것 |
|---|---|---|
| 쓰는 모델 | Claude Opus 5.5, Midjourney, Suno와 '다른 주요 API'(머스크 게시물) | 어떤 작업을 어느 회사 모델에 보내는지 |
| 모델 선택 | 작업마다 가장 좋은 결과를 낼 모델을 고른다는 방향 | 선택 기준, 사용자가 직접 고르거나 끌 수 있는지 |
| 기록 | 기존 사용 분석에 요청별 처리 모델과 대체 모델이 표시됨(Implicator) | 새로 붙는 외부 모델에도 같은 수준으로 남는지 |
| 기업 통제 | 기업 관리자의 허용 모델 목록은 기본 적용되지만 강제는 보장하지 않는다고 안내(Implicator) | 외부 모델이 추가된 뒤 허용 목록이 어떻게 적용되는지 |
| 데이터·비용 | 발표에 언급 없음. 답글에서 개인정보 처리와 옵트아웃 질문이 이어짐 | 외부 회사로 넘어가는 맥락의 범위, 요금과 사용 한도 반영 방식 |
Runtime Wire는 이 발표를 기술 출시가 아니라 방향 발표로 정리했습니다. 회사가 읽어야 할 것은 발표보다 이 표의 오른쪽 칸입니다. 같은 질문이 Grok Bot뿐 아니라 여러 모델을 섞어 쓰는 모든 에이전트 제품과 외주 구축에 그대로 해당하기 때문입니다.
에이전트는 왜 여러 회사 모델을 섞어 쓰게 되나
작업마다 잘하는 모델과 싼 모델이 다르기 때문입니다. 같은 주에 OpenAI는 판정 전용 Decisions API를 공개 베타로 열었고(10월 6일), Anthropic은 입력 100만 토큰당 0.10달러부터 시작하는 Claude Haiku 5.5를 냈습니다(10월 7일). 다음 날 구글 클라우드도 업무용 Gemini 에이전트가 작업마다 Gemini와 Claude 모델 중 맞는 것을 골라 쓴다고 발표했습니다. 분류와 판정은 소형 모델이나 결정 모델에, 문서 작업과 다단계 업무는 중간 모델에, 가장 어려운 추론은 상위 모델에, 이미지와 음악은 전용 모델에 보내는 구성이 비용과 품질 모두에서 유리해졌습니다. 머스크의 발표는 자체 모델을 가진 회사가 이 흐름을 인정했다는 데 의미가 있습니다.
여러 모델을 쓰는 에이전트를 도입할 때 회사가 정할 다섯 가지
- 작업별 모델 배정. 어떤 작업을 어느 회사의 어느 모델에 보내는지 표로 적고, 바꿀 때는 같은 시험 세트로 다시 잰 뒤 바꿉니다. '알아서 가장 좋은 모델'은 운영 기준이 될 수 없습니다.
- 데이터 경계. 모델 회사마다 보관 기간, 학습 사용 여부, 처리 지역이 다릅니다. 개인정보와 영업 비밀이 들어가는 작업은 보낼 수 있는 모델을 따로 정하고, 필요하면 보내기 전에 비식별화합니다.
- 허용 모델 목록은 시스템으로 강제. 관리자 설정이 '기본 적용'에 그치면 계약상 재위탁 제한을 지킬 수 없습니다. 허용되지 않은 모델로 가는 호출은 중간 게이트웨이에서 막혀야 합니다.
- 호출마다 기록. 요청별로 어떤 모델이 처리했는지, 대체 모델로 넘어갔는지, 무엇을 보냈고 무엇을 받았는지 회사 쪽 로그에 남깁니다. 결과가 달라졌을 때 모델 교체가 원인인지 확인할 수 있어야 합니다.
- 비용 한도. 상위 모델로 올리는 조건과 작업당·월별 상한을 코드로 정합니다. 외부 모델 비용이 요금제 사용량에 어떻게 잡히는지는 계약서로 확인합니다.
노벤티스는 어떻게 하나
노벤티스는 고객사 에이전트의 모델을 한 회사에 묶지 않고 작업 구간별로 배정합니다. 모델을 바꿀 때는 고객사 데이터로 만든 같은 회귀 시험을 통과한 구간만 교체하고, 판정이 필요한 지점은 결정 모델에 맡기되 다음 단계는 코드가 정합니다. AX 진단에서 어떤 업무를 어느 수준의 모델에 맡길지와 사람이 승인할 지점을 나누고, 업무 하나를 대상으로 4~8주 안에 PoC로 검증합니다.
이 글이 맞는 독자: 직원들이 Grok Bot이나 dots 같은 에이전트 제품을 쓰기 시작한 회사, 여러 모델을 쓰는 에이전트 구축을 외주로 검토하는 운영·보안 책임자입니다.
자주 묻는 질문
- 머스크는 Grok Bot에 대해 무엇을 발표했나요?
- 2026년 10월 7일 X 게시물에서 Grok Bot이 앞으로 작업마다 가장 좋은 백엔드 모델을 쓰고, Claude Opus 5.5, Midjourney, Suno 같은 다른 회사 API도 포함한다고 밝혔습니다. 어떤 작업을 어느 모델에 보내는지, 데이터와 비용은 어떻게 처리하는지는 아직 공개되지 않았습니다.
- 에이전트의 모델 라우팅이란 무엇인가요?
- 에이전트가 작업 종류에 따라 다른 AI 모델을 골라 쓰는 방식입니다. 분류는 소형 모델이나 결정 모델, 문서 작업은 중간 모델, 어려운 추론은 상위 모델, 이미지와 음악은 전용 모델에 보내 비용과 품질을 함께 맞춥니다.
- 여러 모델을 쓰는 에이전트에 회사 데이터를 넣어도 되나요?
- 어느 작업이 어느 회사 모델로 가는지 확인하기 전에는 개인정보와 영업 비밀을 넣지 마세요. 모델 회사마다 보관, 학습 사용, 처리 지역 조건이 다르므로 허용 모델 목록을 정하고 시스템이 그것을 강제하는지 확인해야 합니다.
- 에이전트 구축 업체에는 무엇을 확인해야 하나요?
- 작업별 모델 배정표, 허용되지 않은 모델 호출을 막는 방식, 요청별 처리 모델 기록, 모델 교체 시 재시험 절차, 상위 모델 비용 한도를 문서로 받으세요. 노벤티스는 이 구조로 업무 하나를 4~8주 안에 PoC로 검증합니다.