Jev와 '시스템 1' 모델: LLM에게 결정을 맡기지 말고 판정만 받아라
2026년 9월 TypeSafe AI가 공개한 Jev는 텍스트가 아니라 타입이 정해진 값과 보정된 확률만 돌려주는 결정 모델입니다. 10월 6일에는 OpenAI도 같은 방식의 Decisions API를 공개 베타로 열었고 10월 22일 정식 출시했습니다. 왜 이런 모델이 필요해졌는지, 두 선택지는 무엇이 다른지, 검증되지 않은 주장은 무엇인지, AX 에이전트에서 코드가 제어 흐름을 소유하게 만드는 방법을 노벤티스의 적용 방식으로 설명합니다.
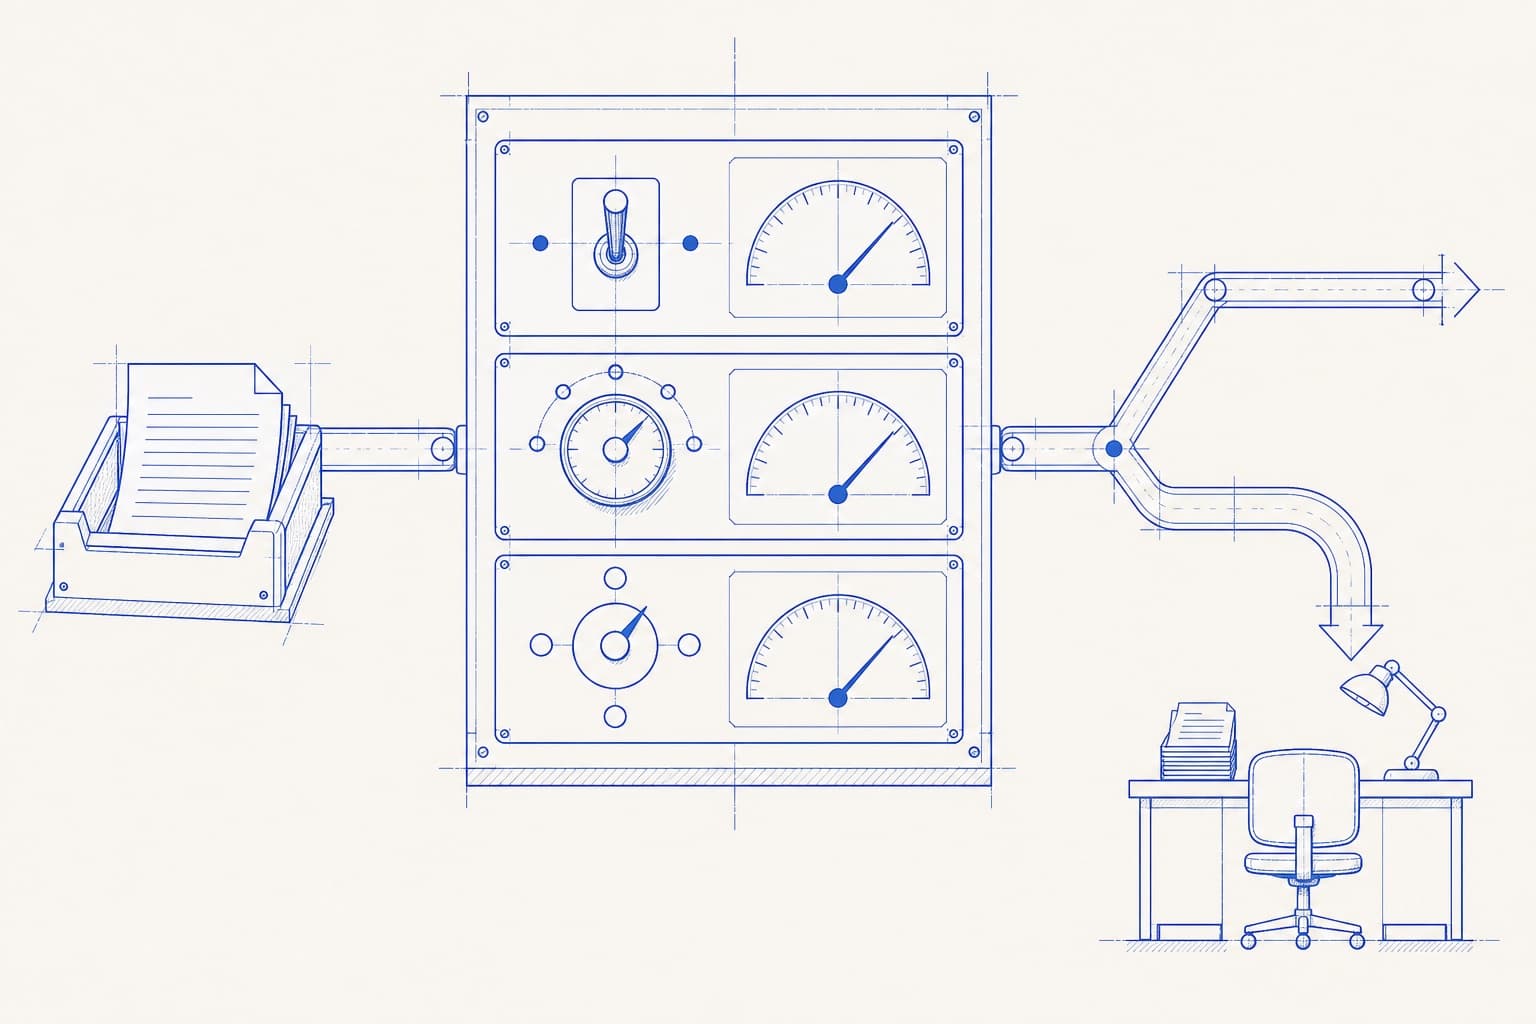
2026년 9월 15일, 샌프란시스코의 TypeSafe AI가 4,000만 달러 시드 투자와 함께 첫 모델 Jev를 공개했습니다. 챗 모델처럼 토큰을 하나씩 생성하지 않고, 상태(이메일, 로그, 티켓, JSON)와 타입이 정해진 질문 목록을 받아 '보기 중 선택', '루브릭 점수', '예/아니오'를 각각 보정된 확률과 함께 한 번에 돌려줍니다. 카너먼의 '빠른 사고'에서 이름을 따 '시스템 1 모델'이라 부릅니다. 발표 수치는 지연 70~500ms, 입력 100만 토큰당 0.042달러(출력 무료), 컨텍스트 64K입니다.
왜 결정 모델이 필요해졌나
범용 LLM에 '이 문서를 보고 알아서 처리해'라고 맡기면 데모는 인상적이지만 운영에서는 결과가 매번 조금씩 다르고, 왜 그렇게 판단했는지 구조적으로 남지 않습니다. 결정 모델은 그 반대를 지향합니다. 정해진 스키마로만 답하고, 확률이 실제 정답률과 맞도록(발표 자료의 RLCD) 훈련합니다. 90%라고 답한 것들은 실제로 90% 정도 맞아야 한다는 뜻입니다. 이 성질이 있어야 '확신이 낮으면 사람에게'라는 라우팅이 성립합니다.
아직 검증되지 않은 것
독립 리뷰들은 벤치마크가 자체 채점이고, 아키텍처와 가중치가 비공개이며, 대기 명단 방식의 초기 접근이고, 32K 텍스트 전용 상태 예산이 실제 업무의 상당수를 배제한다고 지적합니다. '환각이 수학적으로 불가능하다'는 문구는 '스키마 밖 값을 내지 않는다'로 읽어야지 '틀리지 않는다'로 읽으면 안 됩니다. 노벤티스는 이런 모델을 쓸 때 공급자의 속도·가격 주장을 실측으로 간주하지 않고, 우리 데이터로 다시 잽니다.
OpenAI Decisions API는 Jev와 무엇이 다른가
2026년 10월 6일, OpenAI는 DevDay(9월 29일)에서 초대 방식 프리뷰로 보였던 Decisions API를 모든 개발자에게 공개 베타로 열었습니다. GPT-6 Luna 기반 전용 엔드포인트로, 텍스트와 이미지를 받아 조건이 참일 확률(predicate), 정해진 보기 중 선택(choice), 순서가 있는 기준에 따른 점수(score) 세 가지로만 답합니다. Jev의 '예/아니오, 보기 중 선택, 루브릭 점수'와 같은 구조입니다. 판정 전용 모델이 한 스타트업의 실험에서 주요 모델 회사의 표준 API로 넘어왔다는 뜻입니다.
| 항목 | Jev (TypeSafe AI) | OpenAI Decisions API |
|---|---|---|
| 답의 형태 | 예/아니오·보기 중 선택·루브릭 점수, 보정된 확률 | 확률(predicate)·보기 선택(choice)·점수(score), 답마다 거절(refusal) 가능 |
| 입력 | 텍스트 상태, 컨텍스트 64K | 텍스트와 이미지(base64 인라인만, URL·파일 ID 불가), 컨텍스트 한도는 문서에 명시 없음 |
| 가격 | 입력 100만 토큰당 0.042달러, 출력 무료 | 입력 100만 토큰당 0.10달러, 출력·캐시 무료(지역 처리·장문 할증 별도) |
| 속도 주장 | 지연 70~500ms | GPT-6 Luna를 Responses API로 부를 때보다 최대 10배 빠름(벤치마크 미공개) |
| 접근·데이터 | 대기 명단 방식 초기 접근 | 모든 개발자 공개 베타, 정식 출시는 '수 주 내'. 자격 고객에게 ZDR·HIPAA, 처리 지역은 미국·유럽 |
어느 쪽이든 앞의 경고는 그대로입니다. 두 회사 모두 속도는 자체 주장이고, 확률이 실제 정답률과 맞는지는 우리 업무 데이터로 다시 재야 합니다. OpenAI 문서도 라벨이 붙은 예시로 문턱을 정하고 오탐과 미탐의 비용을 따져 보라고 권합니다. 또 필드 추출이나 설명문이 필요하면 Structured Outputs를, 도구 호출이 필요하면 function calling을 쓰라고 구분합니다. 판정과 생성을 나누라는 이 글의 원칙과 같은 방향입니다. 한국 기업이 따로 볼 점은 처리 지역입니다. 공개된 선택지가 미국과 유럽뿐이므로 개인정보가 들어가는 판정은 입력 전에 비식별화하거나 처리 위치 요건을 먼저 확인하세요.
10월 22일 정식 출시로 무엇이 바뀌었나
OpenAI는 2026년 10월 22일 Decisions API를 정식 출시(GA)했습니다. 공개 베타 이후 바뀐 점은 이렇습니다. 요청 하나에 넣을 수 있는 질문이 400개로 두 배가 됐고, 이미지 외에 JSON 입력을 그대로 넣을 수 있으며 질문 설명에도 이미지를 넣을 수 있습니다. 반복해 쓰는 문맥에 프롬프트 캐시가 붙어 캐시 입력은 100만 토큰당 0.01달러이고, 일반 입력은 그대로 0.10달러에 출력 요금은 없습니다. 처리 지역(inference residency)은 미국과 유럽이고 자격이 되는 고객에게는 데이터 무보관(ZDR)을 제공합니다. 음성 모델 GPT-Live와 바로 연결돼 상담 통화 중에 '되묻기·담당자 연결·상위 보고' 같은 분기를 고를 수 있고, 아시아 여러 지역에 처리 용량을 늘렸다고 밝혔습니다.
OpenAI가 공개한 사내 사용 예도 판정에 한정돼 있습니다. 개인 금융팀은 거래 내역 설명을 분류하고, 커뮤니케이션팀은 보도를 주제별로 나누고 핵심 메시지를 뒷받침하는지 점수를 매겨 사람이 더 볼 기사를 고릅니다. OpenAI는 시작 방법으로 애플리케이션이 자주 내리는 반복 결정 하나를 골라 질문과 가능한 답을 정하고 실제 사용과 비슷한 예시로 시험하라고 권합니다. 이 글의 원칙과 같습니다. 한국 기업에서 달라진 점은 아시아 처리 용량이 늘었다는 것뿐이고, 처리 지역 선택지는 여전히 미국과 유럽입니다. 개인정보가 들어가는 판정은 비식별화나 처리 위치 요건 확인이 먼저입니다.
노벤티스가 적용하는 규칙
- 코드가 제어 흐름을 소유한다. 다음에 무엇을 할지는 코드가 정하고, 모델은 분기에 필요한 판정 값만 준다.
- 의미 검증만 묻는다. '이 답변이 브랜드를 언급했는가', '이 권고가 근거와 모순되는가'처럼 사람이 읽어야 아는 것만 모델에게 묻고, 형식 검사는 코드로 한다.
- 신뢰도 기반 라우팅. 문턱 아래는 자동 처리하지 않고 사람 검토 큐로 보낸다. 모델 응답이 계약과 다르거나 호출이 실패하면 보류(HOLD)로 남기고 지표에 승격하지 않는다.
- 비용 통제도 하네스다. 요청당 항목 수와 글자 수 상한, 조직별 호출 제한, 같은 입력에 대한 캐시를 코드에 둔다.
노벤티스는 AI 답변 모니터링 제품에서 브랜드 언급·추천 여부·긍정/부정 판정에 결정 모델을 '보조 검수'로 씁니다. 언급 위치나 출처 유형처럼 규칙으로 확인 가능한 것은 코드가 판정하고, 의미가 필요한 것만 모델에 묻습니다. 고객사 업무 자동화에서도 같습니다. 견적 요청 분류, 문의 라우팅, 콘텐츠 검수처럼 '판정'이 필요한 지점만 결정 모델에 맡기고 나머지는 코드로 고정합니다. AX에서 신뢰는 모델의 똑똑함이 아니라 판정이 구조화돼 있는지에서 나옵니다.