사내 데이터로 숫자를 답하는 AI 에이전트, 업무 용어 정의부터: 엔비디아 Auto Ontology로 본 구축 확인법
사내 데이터에 '지난달 매출'이나 '활성 고객 수'를 묻는 AI 에이전트는 SQL보다 그 말의 회사 기준을 먼저 알아야 틀리지 않습니다. 엔비디아가 GitHub에 공개한 Auto Ontology(Apache 2.0)는 업무 용어 정의 층을 만들어 쿼리를 정의·데이터 계보와 대조하고 답마다 실행한 SQL과 출처를 붙입니다. 이 설계로 숫자 답 에이전트를 맡길 때 회사가 정할 것과 업체에 물을 질문을 정리했습니다.
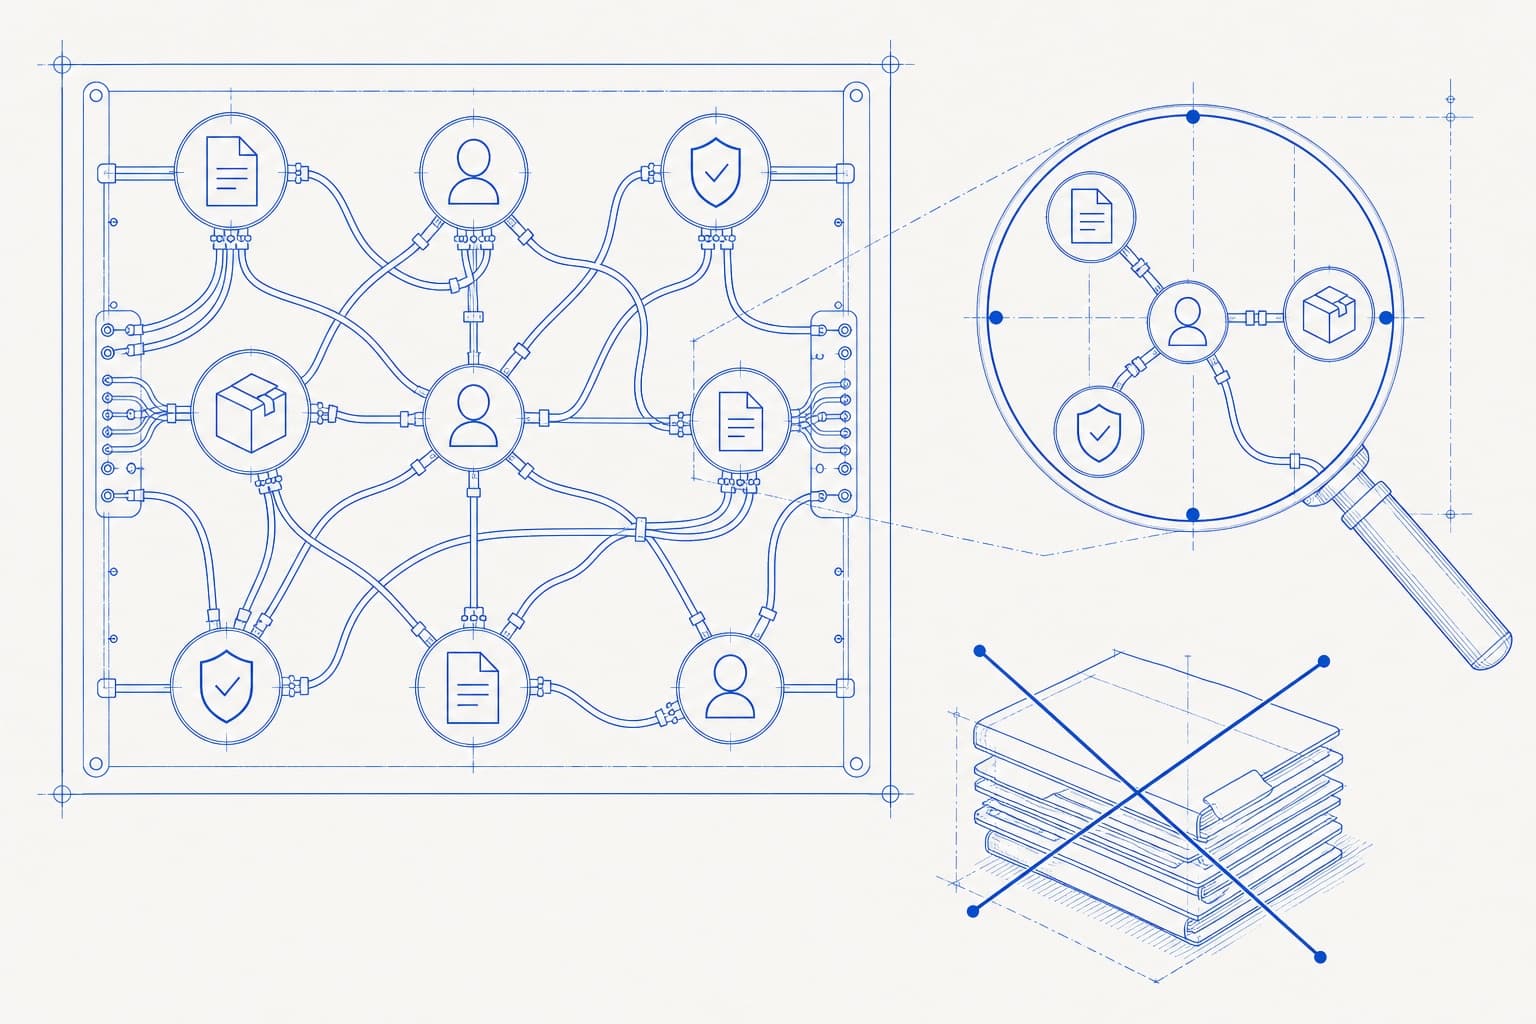
사내 데이터에 "지난달 매출"이나 "활성 고객 수"를 묻는 AI 에이전트는 SQL을 잘 쓰는 것보다 그 말이 우리 회사에서 무엇을 뜻하는지를 먼저 알아야 틀리지 않습니다. 영업팀과 재무팀의 매출 기준이 다르고 시스템마다 고객 테이블이 따로 있으면, 에이전트는 그럴듯한 SQL로 빠르게 틀린 숫자를 냅니다. 엔비디아가 GitHub에 공개한 Auto Ontology도 설명 첫 문단에서 "a revenue metric answered faster is worth nothing if the number is wrong"이라고 적었습니다. 그래서 숫자를 답하는 에이전트를 맡길 때는 지표 정의표, 데이터 위치, 답에 붙일 근거, 사용자별 권한을 구축 범위에 넣어야 합니다.
Auto Ontology는 무엇을 하나
Auto Ontology는 GeekNews가 2026년 11월 3일 소개한 엔비디아의 공개 라이브러리이고 Apache 2.0 라이선스로 배포됩니다. README에 따르면 이 도구는 기업 메타데이터로 온톨로지, 곧 업무 용어의 정의와 데이터 사이의 관계를 정리한 층을 만듭니다. 이 층은 에이전트에게 데이터가 어디 있는지, 무엇을 뜻하는지, 써도 되는지, 어떻게 쓰는지, 어디서 왔는지, 비슷한 데이터가 무엇인지를 알려 줍니다. 시스템마다 다른 정의를 맞추고 회사가 이미 가진 의미 모델을 대체하지 않고 보완한다고 적었습니다.
동작은 네 단계로 설명됩니다. 메타데이터에서 정의를 찾아 묶고 에이전트에게 지표와 대상의 업무 의미를 줍니다. 에이전트가 만든 쿼리는 인증된 정의와 데이터 계보에 대조해 검증하고 답마다 출처를 붙입니다. 사람이 확인한 수정 사항과 사용 기록은 다시 온톨로지에 반영합니다. 연결 대상은 Databricks, PostgreSQL, Snowflake, DuckDB이고 모델은 엔비디아 NIM(호스팅 또는 자체 호스팅)이나 회사가 정한 OpenAI 호환 엔드포인트를 씁니다.
에이전트 연결(MCP)에서 볼 설계
에이전트와 붙는 부분인 MCP 서버 문서에는 회사가 그대로 가져다 쓸 만한 원칙이 있습니다. 공개된 도구는 모두 조회용이고 용어집, 카탈로그, 원본 데이터베이스를 고치지 않습니다. 데이터베이스나 원시 테이블을 둘러보는 도구는 일부러 두지 않았습니다. 에이전트가 원시 테이블을 보고 추측하지 말고 업무 의미 층을 거쳐 데이터에 닿게 하려는 것입니다. MCP 서버는 데이터베이스 자격 증명을 갖지 않고 로그인한 사람의 권한을 그대로 따르므로, 열람 권한만 있는 사람은 열람 범위의 답만 받습니다.
질문을 실행하기 전에 의미 층이 그 질문을 다룰 수 있는지 먼저 점검하는 도구도 있습니다. 답을 줄 때는 답과 함께 실제로 실행한 SQL과 결과 행을 돌려줍니다. 숫자를 받은 사람이 그 숫자가 어떤 정의와 쿼리에서 나왔는지 바로 확인할 수 있다는 뜻입니다.
이 도구를 바로 써야 하나
다만 이 도구를 바로 도입하라는 뜻은 아닙니다. README는 외부 기여를 받지 않는다고 적었고 텍스트-SQL 벤치마크는 별도 저장소로 안내할 뿐 결과 수치를 싣지 않았습니다. 한국어 업무 용어나 한국어 질문에 대한 평가도 문서에 나오지 않습니다. 회사가 가져갈 것은 제품보다 설계 원칙입니다. 정의를 먼저 정하고 에이전트는 정의를 거쳐서만 데이터를 읽고 모든 숫자에 근거를 붙이는 것입니다.
| 틀리는 곳 | Auto Ontology 문서의 장치 | 구축 때 확인할 것 |
|---|---|---|
| 부서마다 다른 지표 정의 | 시스템마다 다른 정의를 맞춘 업무 용어 층(온톨로지) | 지표 이름·계산식·기준 테이블·담당 부서·제외 조건을 정한 정의표가 있는가 |
| 원시 테이블을 보고 추측 | 원시 테이블·스키마를 둘러보는 MCP 도구를 일부러 두지 않음 | 에이전트가 정의를 거쳐서만 데이터를 읽는가 |
| 근거 없는 숫자 | 답과 함께 실행한 SQL·결과 행·출처를 돌려줌 | 답마다 실행한 쿼리와 적용한 정의가 붙는가 |
| 권한 밖 데이터 노출 | MCP 서버는 자격 증명 없이 로그인한 사람의 권한을 그대로 따름 | 사용자 권한대로 결과가 걸러지는가, 에이전트 계정이 전체 권한을 갖지 않는가 |
| 답할 수 없는 질문에 답함 | 실행 전에 의미 층이 질문을 다룰 수 있는지 점검하는 도구 | 정의가 없는 질문은 답하지 않고 담당자에게 넘기는가 |
| 데이터를 고치는 사고 | 공개된 MCP 도구는 모두 조회용 | 읽기 전용 계정으로 연결하는가 |
작게 시작하는 법: 지표 정의표 한 장
중소·중견기업이라면 처음부터 지식 그래프를 만들 필요는 없습니다. 에이전트에게 묻게 할 지표 10~20개를 골라 이름, 계산식, 기준 테이블, 담당 부서, 제외 조건을 한 장에 적는 것으로 시작할 수 있습니다. 이 표가 곧 작은 온톨로지이고 에이전트의 답을 검수할 정답지의 기준이 됩니다.
회사가 정할 것
- 지표 범위: 에이전트에게 묻게 할 지표 10~20개를 고르고 그 밖의 질문은 담당자에게 넘깁니다.
- 정의표 주인: 지표마다 계산식과 기준 테이블을 정하고 승인할 부서를 정합니다.
- 근거 표시: 답마다 실행한 쿼리와 적용한 정의를 함께 보여 주게 합니다.
- 권한: 에이전트는 읽기 전용으로 연결하고 결과는 질문한 사람의 권한으로 거릅니다.
- 정의 변경: 정의가 바뀌면 누가 언제 정의표와 정답지에 반영할지 정합니다.
구축 업체에 물을 질문
- 지표 정의표는 누가 만들고 누가 승인하나요? 착수 전에 몇 개 지표를 정하나요?
- 에이전트가 원시 테이블을 직접 읽나요, 정의를 거쳐 읽나요?
- 답에 실행한 SQL과 적용한 정의가 붙나요? 정의가 없는 질문은 어떻게 처리하나요?
- 에이전트 계정의 데이터베이스 권한은 읽기 전용인가요? 사용자 권한대로 결과가 걸러지나요?
- 정답지로 쓸 질문과 숫자는 무엇이고, 정의가 바뀌면 누가 다시 재나요?
노벤티스는 어떻게 다루나
노벤티스는 AI 에이전트를 설계할 때 업무별 입력·출력·승인 규칙과 실패 시 사람에게 넘기는 조건을 먼저 정하고 과거 처리 사례로 만든 정답지로 결과를 잽니다. 데이터는 기존 시스템에 둔 채 연결하고 사내 문서 검색은 검색 단계에서 사용자 권한으로 먼저 거르며 근거를 찾지 못하면 답을 지어내지 않고 담당자에게 넘깁니다. 위 표와 점검 항목은 공개된 문서를 바탕으로 정리한 일반 원칙이며 노벤티스의 특정 사례가 아닙니다. 첫 프로젝트는 업무 하나를 대상으로 4~8주 안에 PoC까지 진행하고 범위와 비용은 진단 미팅 후 서면 견적으로 정합니다.
이 글이 맞는 독자: 사내 DB·ERP·CRM 데이터에 자연어로 숫자를 묻는 AI 에이전트를 검토하는 회사, 데이터 분석 에이전트 구축 제안서를 비교하는 IT·데이터 책임자입니다.
자주 묻는 질문
- 사내 데이터 AI 에이전트가 숫자를 틀리는 이유는 무엇인가요?
- 데이터 표를 읽을 수 있어도 '매출', '활성 고객' 같은 말의 회사 기준을 모르면 틀린 숫자를 냅니다. 부서마다 계산식이 다르거나 비슷한 테이블이 여러 개 있으면 에이전트가 그중 하나를 골라 그럴듯한 SQL을 만듭니다. 그래서 지표 정의를 먼저 정하고 답마다 실행한 SQL과 기준을 붙이게 해야 합니다.
- 엔비디아 Auto Ontology는 무엇인가요?
- 엔비디아가 GitHub에 공개한 오픈소스 라이브러리(Apache 2.0)입니다. 기업 메타데이터로 업무 용어의 정의와 데이터 관계를 정리한 층을 만들고 에이전트가 만든 쿼리를 정의와 데이터 계보에 대조해 검증하며 답마다 출처를 붙입니다. MCP·CLI·API로 에이전트에 연결하고 MCP 도구는 조회만 합니다.
- 사내 데이터 에이전트를 만들려면 온톨로지나 지식 그래프가 꼭 있어야 하나요?
- 꼭 그렇지는 않습니다. 에이전트에게 묻게 할 지표 10~20개의 이름, 계산식, 기준 테이블, 담당 부서, 제외 조건을 한 장에 정리하는 것으로 시작할 수 있습니다. 질문 범위가 넓어지고 시스템이 많아질 때 Auto Ontology 같은 도구나 기존 의미 모델을 검토하면 됩니다.
- 데이터 분석 에이전트 구축 업체에는 무엇을 물어야 하나요?
- 지표 정의표를 누가 만들고 누가 승인하는지, 에이전트가 원시 테이블을 직접 읽는지 정의를 거쳐 읽는지, 답에 실행한 SQL과 기준이 붙는지, 사용자 권한대로 결과가 걸러지는지, 정의가 바뀌면 누가 언제 반영하는지를 물어 보세요. 정답지로 쓸 질문과 숫자도 착수 전에 함께 정하세요.